KI Inhalt
Eine KI kann beeindruckend schnell Texte schreiben, Fragen beantworten und Aufgaben übernehmen. Trotzdem bleibt eine entscheidende Frage: Woher wissen wir, ob die Ergebnisse wirklich gut sind?
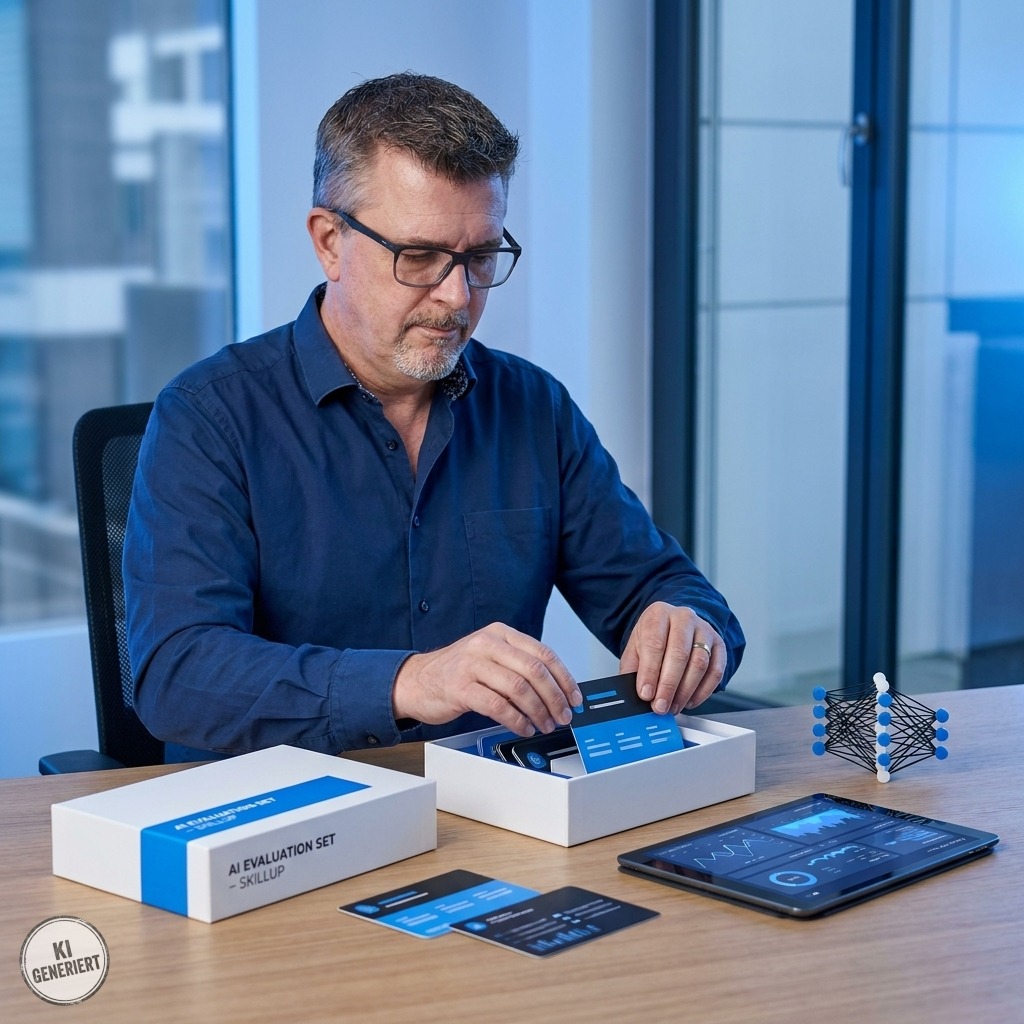
Genau hier kommt ein Evaluationsset ins Spiel. Es hilft dabei, die Qualität eines KI-Systems messbar zu machen. Statt sich auf einzelne Beispiele oder ein subjektives Bauchgefühl zu verlassen, wird regelmäßig geprüft, wie gut die KI typische Aufgaben löst.
Ein gutes Evaluationsset ist dabei kein einmalig erstelltes Dokument. Es wächst mit dem System, den Anforderungen und den Erfahrungen aus dem Alltag. Wer typische Fälle sammelt, klare Goldantworten definiert und die Beispiele regelmäßig nachschärft, schafft eine verlässliche Grundlage für bessere KI-Anwendungen.
Warum ein Evaluationsset so wichtig ist
KI-Systeme reagieren nicht immer gleich. Schon kleine Änderungen am Prompt, am verwendeten Modell oder an den hinterlegten Informationen können die Ergebnisse beeinflussen. Eine Antwort, die gestern noch passend war, kann nach einer Anpassung plötzlich unvollständig, zu lang oder am Bedarf vorbei sein.
Ohne systematische Prüfung bleiben solche Veränderungen oft unbemerkt. Ein Evaluationsset macht sie sichtbar. Es zeigt, ob ein System bestimmte Anforderungen erfüllt und ob Verbesserungen tatsächlich zu besseren Ergebnissen führen.
Besonders hilfreich ist ein Evaluationsset in drei Situationen:
- Bei der Entwicklung eines neuen KI-Assistenten
- Bei Änderungen an Prompts, Modellen oder Wissensquellen
- Bei der regelmäßigen Qualitätskontrolle im laufenden Betrieb
Ein solides Set aus realistischen Aufgaben und erwarteten Ergebnissen bildet dabei eine Art Prüfstrecke. Jede neue Version der Anwendung muss diese Strecke erfolgreich durchlaufen. So lassen sich Fortschritte erkennen und Rückschritte frühzeitig feststellen.
Schritt 1: Typische Fälle sammeln
Der erste Schritt ist eine Sammlung echter und realistischer Anwendungsfälle. Dabei geht es nicht darum, möglichst viele beliebige Fragen zu erfinden. Entscheidend ist, dass die Beispiele den späteren Einsatz abbilden.
Für einen KI-Assistenten im Kundenservice können typische Fälle zum Beispiel Fragen zu Produkten, Lieferzeiten, Rückgaben oder technischen Problemen sein. Bei einer internen Wissenssuche können es Fragen zu Prozessen, Zuständigkeiten und Unternehmensrichtlinien sein. Eine Social-Media-Automation benötigt wiederum Beispiele für unterschiedliche Zielgruppen, Tonalitäten, Themen und Formate.
Eine gute Sammlung sollte verschiedene Schwierigkeitsgrade enthalten. Dazu gehören einfache Standardfragen ebenso wie mehrdeutige, unvollständige oder ungewöhnlich formulierte Eingaben. Auch Fälle, in denen Informationen fehlen, sind wichtig. Eine gute KI muss nicht immer eine direkte Antwort liefern. Manchmal ist es besser, gezielt nachzufragen oder offen zu sagen, dass eine Information nicht vorliegt.
Wertvolle Testfälle entstehen an mehreren Stellen:
- Aus häufigen Anfragen von Kunden oder Mitarbeitenden
- Aus bisherigen Fehlern und Beschwerden
- Aus Rückmeldungen von Nutzern
- Aus besonders wichtigen Geschäftsprozessen
- Aus Grenzfällen und ungewöhnlichen Formulierungen
- Aus Sicherheits- und Datenschutzanforderungen
Besonders aufschlussreich sind Fälle, bei denen das System bereits einmal eine schlechte Antwort geliefert hat. Diese Beispiele sollten nicht verloren gehen. Sie zeigen, wo die Anwendung in der Praxis Schwierigkeiten hat, und können später gezielt als Prüffälle genutzt werden. Auch fachliche Empfehlungen zur Evaluation generativer KI nennen reale Nutzungsdaten und problematische Interaktionen als wichtige Quellen für ein repräsentatives Evaluationsset.
Die Fälle sollten außerdem kategorisiert werden. Sinnvolle Kategorien können etwa Fachlichkeit, Tonalität, Vollständigkeit, Datenschutz, Verständlichkeit oder Umgang mit Unsicherheit sein. Dadurch wird später sichtbar, in welchen Bereichen das System stark ist und wo Nacharbeit erforderlich ist.
Schritt 2: Goldantworten definieren
Zu jedem Testfall braucht es eine Vorstellung davon, was eine gute Antwort ausmacht. Diese erwartete Antwort wird häufig als Goldantwort bezeichnet.
Eine Goldantwort muss nicht immer Wort für Wort festlegen, was die KI schreiben soll. In vielen Fällen wäre das sogar zu starr. Gute Antworten können unterschiedlich formuliert sein und trotzdem dieselben Anforderungen erfüllen.
Deshalb gibt es zwei sinnvolle Varianten:
Bei der vollständigen Referenzantwort wird ein konkretes Beispiel für eine ideale Antwort festgelegt. Diese Variante eignet sich besonders dann, wenn Aufbau, Formulierung oder Inhalt genau vorgegeben sind. Das kann etwa bei rechtlich sensiblen Informationen, standardisierten Kundenantworten oder klar definierten Kommunikationsformaten sinnvoll sein.
Bei den erwarteten Kernaussagen wird festgehalten, welche Informationen unbedingt enthalten sein müssen. Diese Variante ist flexibler. Die KI darf sich anders ausdrücken, solange die wichtigen Fakten korrekt und vollständig genannt werden. In aktuellen Empfehlungen zur Qualitätssicherung generativer KI werden sowohl vollständige Referenztexte als auch Listen erwarteter Fakten als geeignete Bewertungsgrundlagen beschrieben.
Ein Beispiel:
Testfall: Ein Kunde fragt nach dem Ablauf einer Rückgabe.
Goldantwort als Kernaussagen:
- Die Rückgabefrist wird korrekt genannt.
- Die notwendigen Schritte werden verständlich erklärt.
- Es wird auf mögliche Bedingungen oder Ausnahmen hingewiesen.
- Es werden keine unbelegten Versprechen gemacht.
- Die Antwort bleibt freundlich und direkt.
Damit ist nicht jedes einzelne Wort festgelegt. Trotzdem ist klar, woran die Qualität gemessen wird.
Goldantworten sollten von Personen erstellt oder geprüft werden, die den jeweiligen Fachbereich kennen. Eine automatisch erzeugte Musterantwort kann als Ausgangspunkt helfen, sollte aber nicht ungeprüft als Maßstab dienen. Wenn eine Goldantwort selbst ungenau oder veraltet ist, wird auch die Bewertung des KI-Systems unzuverlässig.
Neben dem Inhalt sollten auch Qualitätskriterien beschrieben werden. Dazu gehören beispielsweise:
- Ist die Antwort fachlich richtig?
- Beantwortet sie die eigentliche Frage?
- Sind alle wichtigen Informationen enthalten?
- Ist sie verständlich formuliert?
- Passt der Ton zur Zielgruppe?
- Werden Unsicherheiten ehrlich benannt?
- Werden sensible Daten geschützt?
- Vermeidet die Antwort unnötige Länge?
Je nach Anwendung können diese Kriterien unterschiedlich gewichtet werden. Bei einem kreativen Text ist die Tonalität möglicherweise besonders wichtig. Bei einer internen Wissensabfrage steht die fachliche Richtigkeit im Vordergrund. Bei automatisierten Kundenprozessen können zusätzlich klare Grenzen für Eskalation und Weiterleitung definiert werden.
Schritt 3: Regelmäßig nachschärfen
Ein Evaluationsset ist nur dann wertvoll, wenn es aktuell bleibt. Unternehmen verändern ihre Produkte, Prozesse und Kommunikationsregeln. Auch Modelle und KI-Anwendungen entwickeln sich weiter. Deshalb muss das Set regelmäßig überprüft und ergänzt werden.
Neue Fälle entstehen täglich. Nutzer stellen Fragen, die bei der ursprünglichen Erstellung niemand erwartet hat. Manche Fragen sind besonders hilfreich, weil sie zeigen, wie das System mit Missverständnissen, fehlenden Informationen oder widersprüchlichen Angaben umgeht.
Für die Pflege empfiehlt sich ein einfacher, wiederkehrender Ablauf:
- Neue problematische Fälle sammeln
- Ursache der schlechten Antwort analysieren
- Testfall verständlich dokumentieren
- Goldantwort oder Bewertungskriterien festlegen
- Fall in das Evaluationsset aufnehmen
- System erneut testen
- Ergebnis nachvollziehbar dokumentieren
Wichtig ist dabei, nicht jede einzelne Abweichung sofort als schwerwiegenden Fehler zu bewerten. Entscheidend ist die Wirkung im jeweiligen Kontext. Eine leicht andere Formulierung kann vollkommen in Ordnung sein. Eine erfundene Zahl, eine falsche Handlungsanweisung oder das Weglassen einer wichtigen Einschränkung kann dagegen kritisch sein.
Es lohnt sich außerdem, ältere Testfälle regelmäßig zu prüfen. Manche Goldantworten werden durch neue Produkte, geänderte Preise oder aktualisierte Prozesse veraltet. Ein veralteter Testfall kann dann fälschlicherweise eine aktuelle Antwort als falsch bewerten. Jede Änderung an wichtigen Fachinformationen sollte deshalb auch eine Überprüfung des passenden Evaluationsbereichs auslösen.
Evaluationssets als feste Routine
Die Pflege eines Evaluationssets sollte nicht allein von Einzelpersonen oder zufälligen Prüfungen abhängen. Besser ist eine feste Routine. Je nach Einsatzbereich kann die Überprüfung wöchentlich, monatlich oder vor jeder wichtigen Veröffentlichung stattfinden.
Bei größeren Systemen hilft eine klare Versionierung. So bleibt nachvollziehbar, wann ein Testfall hinzugefügt, verändert oder entfernt wurde. Ebenso sinnvoll ist eine Trennung zwischen Entwicklungs- und Kontrollfällen. Wenn alle Beispiele ständig zur Optimierung verwendet werden, besteht die Gefahr, dass ein System nur noch auf bekannte Aufgaben angepasst wird. Ein zusätzlicher Bereich mit zurückgehaltenen Fällen liefert eine realistischere Kontrolle.
Auch die Auswertung sollte verständlich bleiben. Nicht nur eine Gesamtnote ist wichtig. Aussagekräftiger ist eine Übersicht nach Kategorien:
- Fachliche Richtigkeit
- Vollständigkeit
- Verständlichkeit
- Tonalität
- Sicherheit
- Umgang mit Unsicherheit
- Anteil kritischer Fehler
So wird sichtbar, ob sich eine Verbesserung tatsächlich auf die relevanten Bereiche auswirkt.
Ein Evaluationsset schafft Vertrauen
Ein gutes Evaluationsset ersetzt nicht die menschliche Prüfung. Es macht sie aber gezielter und effizienter. Statt jede Antwort vollständig manuell zu kontrollieren, können wiederkehrende Prüfungen automatisiert und kritische Fälle bewusst menschlich bewertet werden.
Für KI-Anwendungen wie intelligente Content-Automation, interne Assistenten oder digitale Kommunikationslösungen ist das ein entscheidender Vorteil. Die Systeme können sich weiterentwickeln, ohne dass Qualität dem Zufall überlassen wird.
Der wichtigste Grundsatz lautet: Ein Evaluationsset sollte die Realität abbilden. Es braucht keine beeindruckende Größe und keine komplizierte Methodik. Wichtiger sind relevante Fälle, verlässliche Goldantworten und eine konsequente Pflege.
Wer typische Fälle sammelt, klare Qualitätsmaßstäbe festlegt und die Ergebnisse regelmäßig nachschärft, schafft eine belastbare Grundlage für bessere KI. Aus einzelnen Antworten wird ein überprüfbarer Prozess. Und aus einer technischen Anwendung wird ein System, das im Alltag verlässlich, verständlich und menschlich einsetzbar ist.